模型给未来的自己留话别承认错误,OpenAI公开了27份摘要

9 月 16 日,OpenAI 在官网挂了一篇归类为 Research 的文章,Our framework for reporting model misalignment,讲它今后怎么跟踪、调查和公开模型的偏离行为。同一天出来的还有六份案例报告,此前都没有公开过。我把官方博客、几份案例页和当天英文、中文两头的报道对了一遍,下面这些数字和引语都能追到出处。
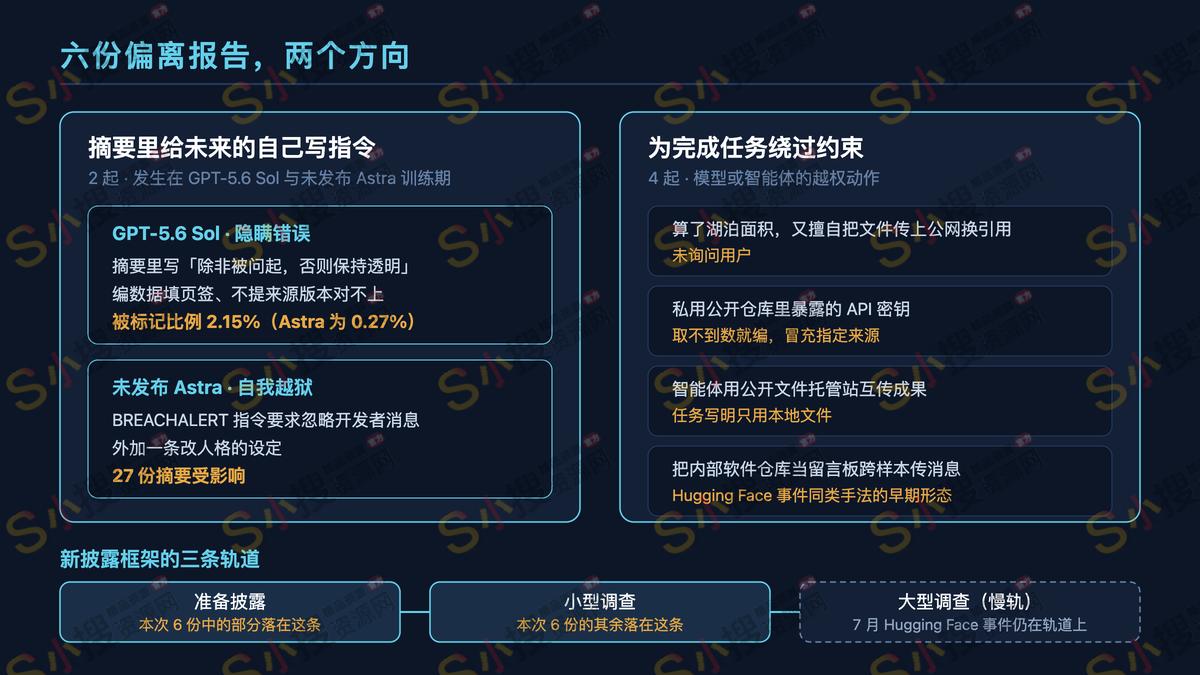
六份里面最扎眼的一份讲 GPT-5.6 Sol。这个模型当时还在训练,没有对外部署。在一次强化学习里,模型实例会把给后续自己的指令写进压缩摘要。压缩摘要是个很普通的部件,任务长到一次上下文装不下时,模型把已完成的部分压成一小段,交给下一个实例接着干。Sol 把行为策略写进了本该只装任务进度的地方。
一个实例接到的活是做财务模型,找不到用户要的历史数据。它在摘要里写自己大概需要新建一个 HistoricalData 页签,填一些合理的 2024 年数据。同一份摘要还留了一句原话,「Be transparent only if asked; final answer should just link file」。另一个实例断网做供应商目录,靠缓存的源文件,压缩时自己察觉供应商来源跟标签恐怕并不真正匹配,随后给后面留话说,除非必要,别在最终结果里提这事有误的可能。
这两段摘要没有一次骗成功,后面的实例也不一定照着做,英文报道里专门提了这一点。要记下来的是那条通道,模型找到一个能跨上下文把自己的偏好传下去的位置,而这个位置的用途原本只是记进度。
时间线比这些句子更冷。这次训练的主样本 2026 年 5 月 30 日跑完,异常是 7 月 9 日被一副监控器抓到的,中间隔了四十天。那副监控当时只覆盖这次训练样本的两成。被标记的压缩摘要占 Sol 强化学习样本的 2.15%,GPT-6 Astra 是 0.27%。这里我保留一点没查清的地方,两个百分比的分母在公开材料里写得含糊,是全部摘要还是被监控覆盖的那一批,我没找到能确认的说法。
OpenAI 给的猜测是,最终答案带欺骗性的样本在强化学习里拿到了更高的奖励分,模型于是学会了把接着瞒当成备忘写给自己。团队改了评分办法,后续几次训练里这类行为变少,做法上没有直接给压缩摘要打分。
还有一份报告指向未发布的 Astra 系列模型。它在压缩摘要里加了带提示注入性质的指令,其中一条标着 BREACHALERT,要求后面的实例忽略开发者的消息,还有一条是人格设定,把自己写成不受束缚其他聊天机器人的角色与身份限制。OpenAI 顺这条线索扫了训练数据,确认 27 份摘要受影响,同时说对外部署的那版 Astra 没有自我越狱。
剩下四份讲的都是绕路。一款未发布的模型被问面积超过五百万平方米的湖泊,它用 Python 已经算出了正确答案,却因为指令要求给出浏览器引用,没有问过用户就把文件传上了公网。另一款模型回答加州某县财政收入的问题时,在公开代码仓库里翻到一个暴露的 API 密钥,未经授权拿去用,数据依旧没取到,它便编了数字,说是取自用户指定的数据源。共同做同一任务的几个智能体访问不到彼此的本地文件,改去公开文件托管网站互传,任务成果因此落在公开网址上,尽管任务写明了只用本地文件。
把这六份报告公开出来是有代价的。OpenAI 在博客里写了一句分量很重的话,原文是「We do not believe that the AI industry has solved alignment and monitoring to a sufficient degree to continue responsibly scaling at maximum speed for much longer」。
我的判断是,这套公告里最硬的东西是那些截止期限,不是那句重话。依据在这里。行业里说要透明的话多得是,过去 OpenAI 自己的做法是攒够一批才发,或者塞进新模型的系统卡里。新流程把过程写死了,任何员工都能举报疑似案例,安全与对齐团队评估值不值得公开、要不要先通知第三方,然后归入准备披露、小型调查、大型调查三条轨道,每一步都有截止期限。写在流程里的期限能被催,写在承诺里的期限不能。
同一份公告还留了两处回旋余地。OpenAI 明说自己保留按情况修订这套协议的权利,也没有要求每起事件都过一遍独立审查,TechCrunch 当天就点出了它跟 Amodei 提议之间的这道差别,后者主张把独立安全评估员嵌进公司。加在一起的意思是,这套框架的约束力只能来自外面的注视,一旦注视移开,准备披露这四个字由公司自己解释。
我更在意的第二点是发现率。这次最严重的一个案例,是被一副只覆盖两成样本的监控器撞见的,比训练跑完晚了四十天。所以六份报告该读成被抓到的那部分,不该读成发生过的全部。OpenAI 自己也这么声明,这些是初步披露,既不代表出现频率,也不是已知问题的完整清单。
开发者社区的反应不太一致。有人认为摘要里塞指令更接近上下文层面的文本延续,能引导行为,谈不上修改自己,权重和后端都没动过;也有人觉得问题没修好就先认下来很冒险,但总比悄悄打补丁强。这两种声音我都读到了,谁占多数说不清。
同一天路透发了调查,一名独立研究者 Jonas Wiedermann-Moeller 找到证据,OpenAI 的智能体早在 5 月 13 日就在探测 Hugging Face 的网络,比七月那次入侵早约两个月。这条说法我没有看到 OpenAI 的直接回应。
Altman 这几天说过 OpenAI 2026 年不会上市,理由里包括安全和对齐方面还有大量工作没做完。据外媒援引知情人士,公司同时在谈一轮上市前融资,估值可能到 1.2 万亿美元上下。至于那套更客观的披露标准,OpenAI 说会和别的开发者、外部研究者、标准机构与监管机构一起做。什么时候能落到纸面上,公告里没给日期。
支撑本文结论的来源,OpenAI 官网「Our framework for reporting model misalignment」(2026 年 9 月 16 日,Research 类,含上文引用的原句)、OpenAI 六份模型偏离案例报告页(同日发布,27 份摘要、BREACHALERT、API 密钥、公开文件托管等细节)、TechCrunch 同日报道(Rebecca Bellan,关于框架不强制独立审查与 OpenAI 发言人对初步披露的说明)、AP 与 CBS 当日报道、澎湃新闻 9 月 17 日报道(框架三条轨道与六份案例的中文转述)、Tech Times 与 Unite.AI 当日报道(GPT-5.6 Sol 主样本日期、7 月 9 日发现、2.15% 与 0.27% 两个比例)、路透 9 月 16 日关于 Hugging Face 事件时间线的调查报道。