微软高管称这是史上最大劳动盗窃,三年后这句话成了呈堂证据

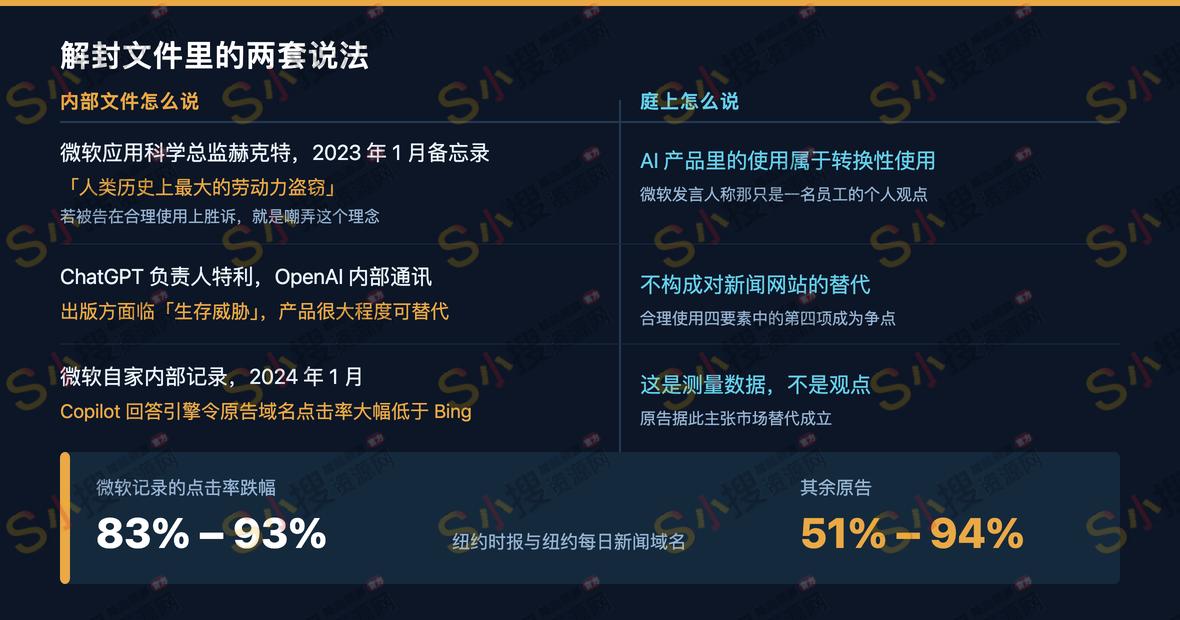
2023年1月,微软应用科学总监布伦特·赫克特在一份内部备忘录里写下,世界各地数百万人很快会认为,大模型"卷走"他们全部作品是一场规模空前的惊人盗窃。他给这件事加了一个更重的定性,"人类历史上最大的劳动力盗窃"。同一份备忘录里还有一句,如果被告在"合理使用"上赢下这场官司,那就是彻底嘲弄"合理使用"这个理念。
那是写给同事看的。三年半以后,它被摊在纽约南区联邦法院的公开卷宗上。
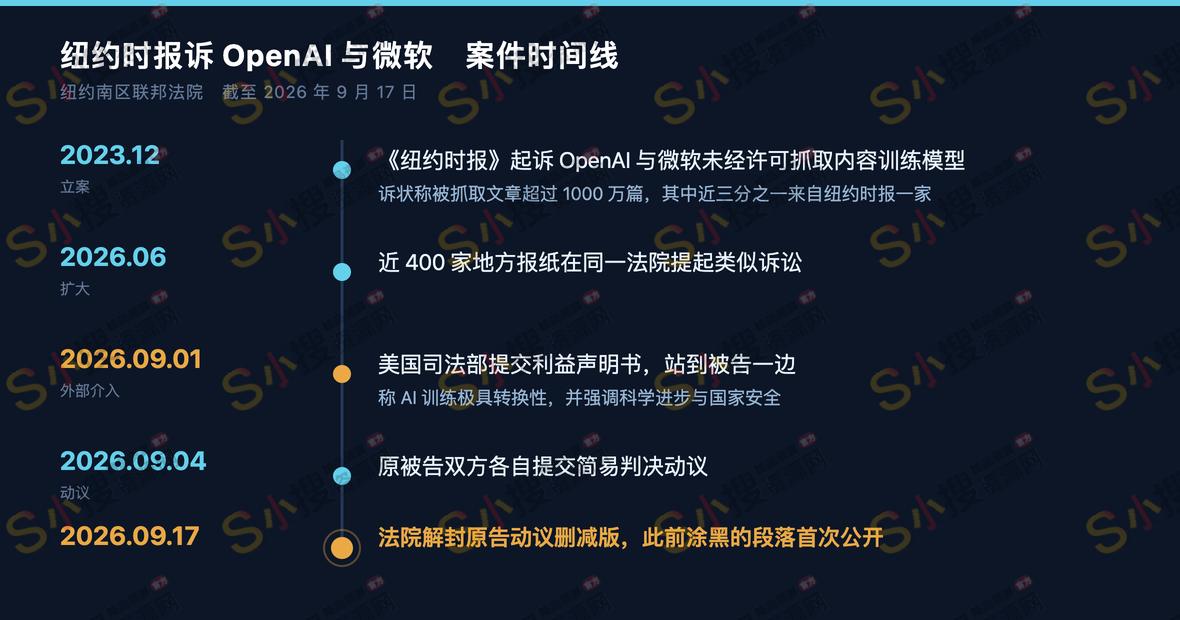
9月17日,法院解封《纽约时报》等出版商提交的简易判决动议的删减版,此前被涂黑的段落第一次公开。这桩官司2023年12月立案,原告控告 OpenAI 与微软未经许可抓取超过1000万篇文章训练模型,其中近三分之一来自《纽约时报》一家。今年6月24日,近400家地方报纸在同一家法院发起类似诉讼。9月4日双方各自提交简易判决动议,9月1日美国司法部提交利益声明书站到被告一边,称 AI 训练极具转换性,并强调科学进步与国家安全。这些日期与数字来自红星新闻对解封文件的报道。
解封材料里最硬的一段落在数字上。微软自己的内部记录显示,Copilot 的回答引擎让《纽约时报》与《纽约每日新闻》域名的点击率比传统 Bing 搜索低 83% 到 93%,另外几名原告的跌幅落在 51% 到 94% 区间。写这份材料的人还是赫克特,时间已经到了2024年1月。他把这种现象叫"doom loop",翻成中文大约是死亡循环,判断它会同时拖垮模型表现和整个网络。材料里有一句近乎白话的总结,终端产品威胁到核心供应商的经济基础,这件事很不寻常,但我们就这样对待大语言模型业务的内容供应链。
OpenAI 那边的内部表述方向一致。ChatGPT 负责人尼克·特利在内部通讯里说出版方面临生存威胁,因为这些产品"在很大程度上是可替代的,句号",并且会随着变强变得越来越可替代。公司总裁格雷格·布罗克曼形容自家模型做新闻很在行。一名工程师的观察更直接,无论把链接摆得多显眼,用户都不会点。
数量级也被摆上了台面。OpenAI 的中间训练数据集里,原告清点出《纽约时报》《纽约每日新闻》与调查报道中心三家作品的完整副本 91,692 份以上。一个基于 Common Crawl 的语料包含 nytimes.com 的文档超过200万篇。微软通过名为 Project Mango 的内部项目整理给 OpenAI 的数据集,至少含原告出版物 160,903 篇独立作品。这些数字出自原告的动议文件,TechCrunch 与 Ars Technica 都做了转述。
还有一条容易被跳过的细节。备忘录提到 OpenAI 后来只屏蔽已起诉原告内容的过滤器,被形容为"意外掩盖",结果是权利人更难知道自己的东西到底有没有被拿去训练。
微软的回应是切割。公司发言人对媒体说,赫克特那些话只反映一名员工的个人观点,既不是法律分析,也不代表公司立场,微软在 AI 产品里的使用属于转换性使用,不构成对新闻网站的替代。《纽约每日新闻》与另外七家姊妹报的代理律师史蒂文·利伯曼针锋相对,首次披露的证据表明 OpenAI 和微软知道自己做的是错的,而整个案子里被告一直坚持要求把这些文件保密,好让公众看不见。
我的判断是,这批材料真正的杀伤力不在"盗窃"两个字,在那份点击率数据。
理由是美国合理使用有四个权衡要素,其中第四项看的正是未授权使用对原作品潜在市场或价值的影响。员工备忘录里的道德判断,法庭完全可以当成个人牢骚处理,微软这层切割站得住。83% 到 93% 属于微软自己测出来的产品效果,它直指市场替代,而这正是原告必须证明的东西。引语可以被解释,自家仪表盘上的读数很难。
另一件事我也想说清楚,现在就断言局势会翻,太早。
依据有两层。TechCrunch 专门提醒过,这批新信息绝大部分出自原告的动议文本,作为原始证据的附件仍然密封,引语是在脱离上下文的状态下流传的;而到目前为止法官对合理使用的态度总体偏向 AI 公司,行政分支这个月还专门递了文件支持 OpenAI。另一层是常识,内部备忘录从来没有单独赢下过一场官司,它能不能和可被质证的证据对上,才是关键。
所以接下来要看程序怎么处理。双方9月4日都交了简易判决动议,法院接下来要么在动议阶段直接给出法律结论,要么把案子送进陪审团审判。走后者的话,这些文件会一份一份被摆到证人席上质证,那时候它们到底是原告的叙事还是被告的自认,才有答案。
这份卷宗里最不需要争论的东西,大概是那份2024年1月的内部材料。微软自己做的,微软自己测的,结论写在上面。