新闻稿说打赢前沿模型,Salesforce 自家论文的表格不同意

在 Salesforce 的 Koa 产品页上,芝加哥大学医学中心首席营销官 Andrew Chang 的推荐语里留着一处没替换掉的占位符,原文写着「The [Placeholder Name] reasoning model」。这条客户证言属于 9 月 15 日 Dreamforce 大会首日的发布物料,同一天英伟达 CEO 黄仁勋走上 Moscone 中心的舞台,站在 Marc Benioff 旁边一起宣布了 Koa。
一个大型软件公司在发布会当天没校完自己的网页,事情不大。把它和这次发布的另一件事放在一起看就有意思了,官方口径和技术论文之间留着一道不算窄的缝。
Koa 是 Salesforce 第一个自己做出来、向外售卖的推理模型,岗位是给 Agentforce 的智能体干 CRM 的活。它不是一个从零训出来的模型,起点是英伟达开放权重的 Nemotron-3-Super-120B,Salesforce 在上面做了监督微调和 GRPO 强化学习,工具链用英伟达的 NeMo RL、NeMo Gym 和 NeMo AutoModel。训练语料全部是合成数据,覆盖制造业、金融服务、医疗、旅行等十四个以上行业,没有一个字节来自客户。Salesforce 对外讲的那个版本是,二十七年做 CRM 积累下来的业务知识被直接写进了模型权重。
好听的部分到这里结束,接下来是数字。
新闻稿里最响的一句是 Koa 在 CRM 动作上达到或超过领先模型的表现,错误率少三倍,标注的出处是技术论文。9 月 14 日提交到 arXiv 的这篇论文编号 2609.15066,共 16 页,摘要里的说法是另一层意思,超过一个强劲的专有基线,同时仍低于最强的前沿模型。
两家官方稿子里还挂着一组更漂亮的数字,动作调用精确度高 11%、上下文召回可靠度提升 2.1 倍、长对话上下文记忆好 15%,但没有写这是跟谁比。
对照论文表一,差距具体是多少。Tau2Bench 客服多轮任务的加权平均分,Koa 拿到 69.41,它的起点 Nemotron-3-Super-120B 是 68.64,GPT-4.1 是 54.48,Claude Opus 4.8 是 74.00,GPT-5.5 是 83.99。函数调用基准 BFCL 上 Koa 是 66.63,同样低于 Opus 4.8 的 78.18 和 GPT-5.5 的 67.63。Salesforce 自己的 CRM Bench 上差距收得最窄,Koa 0.86,GPT-5.5 0.90,Opus 4.8 0.87。同一张表里还有一项 CRM 函数调用准确率,Koa 是 0.77,而 2025 年 4 月就发布的 GPT-4.1 是 0.85。
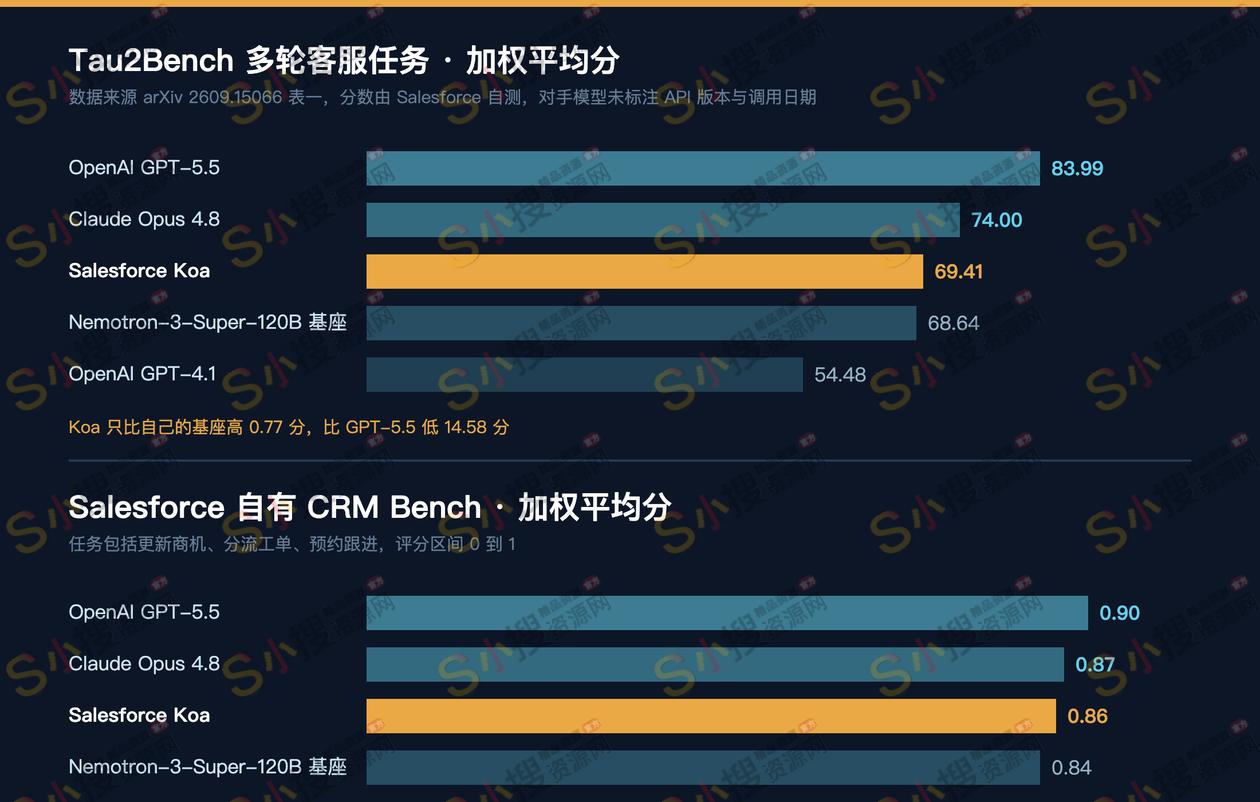
我的判断是,这次发布的变化不在分数,在于动手训练模型的是谁。应用软件公司拿一个开放权重的底座,往里面灌自己的业务流程,权重自己攥着,推理在自己机房里跑,客户既拿不到模型,也不必让数据走出自己的地界。依据是这次发布的几个结构性事实。Salesforce 明确说自己控制 Koa 的权重、在自有信任边界内完成后训练和推理,Koа 不提供下载,也不能在 Agentforce 之外被调用,官网上它作为第四个可选模型提供方进到 Setup 里,与另外几家供应商并列。同一周 Salesforce 还宣布德科集团把基于 Anthropic Claude 的 Agentforce Coworker 铺到四十多个国家、约两万七千名员工。Salesforce 没打算用 Koa 替掉 Claude,它是在给客户多一个不放数据的选择,面向政府和受监管行业的 Missionforce 那条线甚至支持私有云和物理隔离网络。
论文里还有一处容易被发布会盖住的细节。附录 J 的两张消融表比了基座、只做监督微调、只做强化学习三个检查点,对外发货的 Koa 是最后那个「只做强化学习」。在 Tau2Bench 上,只做监督微调的检查点是 70.04,高于 Koa 的 69.41;CRM Bench 上前者 0.88,Koa 是 0.86。两项都优于那个已经发货的版本。
这不该被读成强化学习做错了。论文自己提了限制,基座模型出厂前已经经历过一轮强化学习后训练,所以这里的增量对照不干净。我的判断是,它更像是说明这类企业定制模型的瓶颈落在合成数据和任务规格的编写质量上,最后那段后训练方法能带来的提升有限。依据是论文把工作流规格到奖励的仿真管线当成核心贡献在写,用 Agent Script 写的任务规格被展开成带人格设定的多轮对话,奖励不看回复写得好不好看,只看任务有没有通过正确的工具调用解决掉。论文里那组监督微调对照的训练用了 32 张 H200,主训练的 RL 环节用了 5 个节点的 B200。拉开差距的是那些仿真出来的场景,不是最后的 RL 步骤。
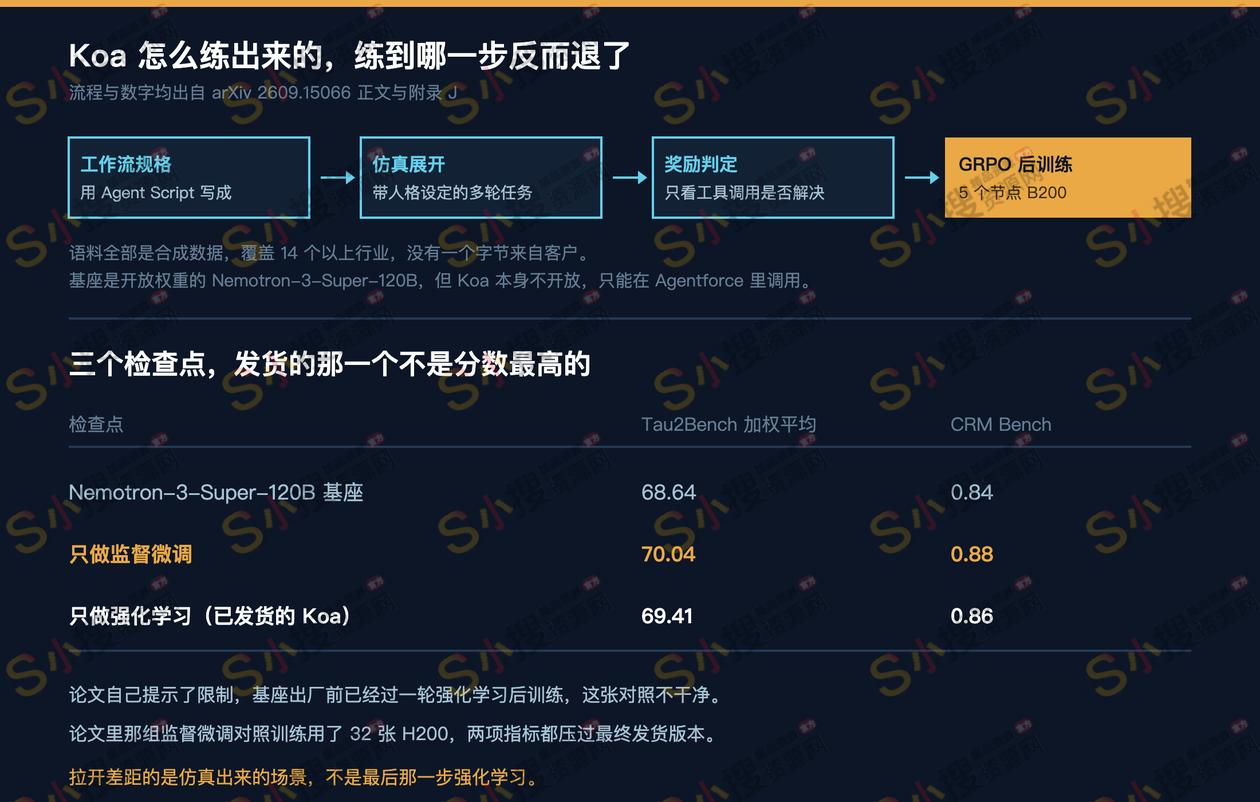
竞品那一列也要打个折扣。论文点了三个专有对手的名字,没有给出任何 API 版本号、调用日期或采样设置,只说明所有检查点都用 vLLM 以 BF16 精度提供服务。这种条件下,横向分数的参考价值有限。Salesforce 在论文里的披露比在新闻稿里诚实,可惜对外传播用的是后一种。
另一个容易被略过的地方是,开放这个词在两家公司嘴里指的不是一回事。Nemotron 是开放权重,黄仁勋在现场说开放模型占比从去年初的三成升到了现在的七成左右,Salesforce 能改能部署靠的正是底座开放。但 Koa 本身不开放,用户只能在 Agentforce 里选它,改不了也搬不走。落到客户手上,这是一个锁得更紧的选项,尽管它建在开源之上。
价格没有公布。时间表是十月起陆续进入客户试点,正式开放预计要等到 2026 年冬季,且目前只写明了美国区域。首批六家试点客户是 1-800Accountant、Baxter Credit Union、Engine、一级方程式赛车、芝加哥大学医学中心和 Xero。芝加哥大学医学中心那条推荐语里,还留着那处没改完的占位符。
支撑本文结论的来源,Salesforce 投资者关系公告(2026 年 9 月 15 日,含三倍错误数与不公开权重等原句)、Salesforce Koa 产品页(精度、可靠度、上下文三项提升与部署方式)、arXiv 2609.15066《Salesforce Koa》这篇面向智能体工具调用的企业语言模型论文(提交于 2026 年 9 月 14 日,表一与附录 J 消融表)、英伟达官方博客关于黄仁勋出席 Dreamforce 的记录(2026 年 9 月 15 日)、CIO 对同一场发布的现场报道(Rohan Kumar 对语料与训练方法的说明)、Salesforce ANZ 与 UK Dreamforce 实时页(同日发布的 AWS 与谷歌云合作、德科集团 Agentforce Coworker 部署)。